Uso de mapeo SQL para agregar un ID único a cada registro
Recientemente, un cliente de FCCS necesitaba incluir un identificador único para cada registro de datos extraído de su aplicación FCCS. Este ID de registro era requerido por una aplicación downstream con fines de indexación. El ID de registro no tenía que comenzar con un valor en particular, pero sí debía ser único para cada fila de datos exportada dentro del archivo. Este cliente en particular utilizaba FCCS, pero no tenía disponible una instancia de EPM Automate. En su lugar, utilizaba llamadas a la API REST realizadas desde herramientas de terceros para la automatización. No pudimos usar ninguna de esas herramientas de terceros para editar el archivo una vez generado, por lo que no podíamos agregar el índice después de creado el archivo. FCCS tiene funcionalidad integrada limitada para extraer datos financieros a archivos de texto. La mayoría de los clientes recurren a Data Management (DM) como método para exportar datos desde FCCS a un archivo plano o de texto para su consumo por aplicaciones downstream.
DM tiene sus propias limitaciones, especialmente en comparación con una implementación on-premise de FDMEE. La falta de scripting en VB o Jython en DM significa que hay opciones limitadas disponibles para controlar datos u objetos durante el procesamiento de datos.
Afortunadamente, DM aún permite el uso de mapeo SQL. El mapeo SQL es una forma de inyectar sintaxis SQL durante la transformación de datos, aparentemente para ampliar los mapeos condicionales. Cuando se asigna al proceso de mapeo de una dimensión, puede ser una herramienta potente que permite a un desarrollador consultar y afectar los datos en las tablas relacionales detrás de escena.
Descripción general del entorno
FCCS es una aplicación basada en cubos, sin capacidades avanzadas o personalizables de extracción de datos. Al exportar datos de FCCS a un archivo de texto, la mejor práctica es usar Data Management (DM). DM también es la herramienta para importar datos desde diversas fuentes (archivo de texto, conexión directa, ODBC, etc.). Aunque no es una herramienta ETL completa, DM sí proporciona herramientas de mapeo, filtrado y programación para la importación y exportación de datos de FCCS.
DM está construido sobre una base de datos relacional. Dado que la base de datos reside en Oracle Cloud, no es posible acceder a los datos ni modificarlos mediante herramientas cliente como SQL Server Management o SQL Plus. Las tablas, vistas y procedimientos almacenados no están expuestos al usuario. Sin embargo, parte de la información sobre el esquema y las tablas sí está documentada.
La información relevante para este proceso es que, al importar datos a DM, los datos se almacenan temporalmente en la tabla llamada TDATASEG_T. Esta tabla se limpia antes y después de cada ejecución de importación o exportación. Toda la manipulación de datos (mapeos, inversión de signos, etc.) se realiza en TDATASEG_T antes de escribirse en la tabla maestra de datos TDATASEG. TDATASEG es la tabla que, en última instancia, almacena y muestra los datos en el workbench de DM.
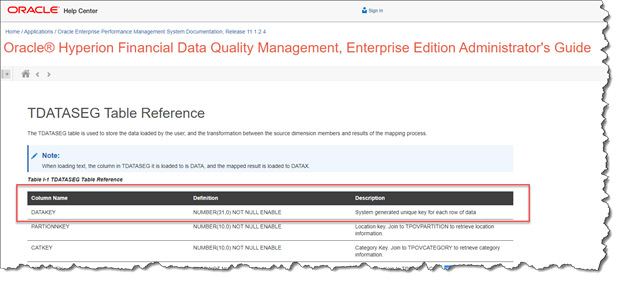
TDATASEG_T y TDATASEG tienen exactamente las mismas propiedades de diseño (campos e índices).
TDATASEG y TDATASEG_T contienen campos para todos los metadatos relevantes (cuenta, entidad, etc.) antes y después de que ocurra la manipulación de datos. También hay un campo llamado DATAKEY, que es un campo de clave primaria en la tabla. DATAKEY es un campo numérico que contiene una clave única generada por el sistema para cada fila de datos.
Recuperar el valor almacenado en el campo DATAKEY de TDATASEG_T durante el proceso de mapeo proporcionará el identificador único necesario para los registros exportados al archivo plano.
Para presentar el contenido del campo DATAKEY en la exportación, es necesario crear una dimensión de metadatos “dummy” en DM para almacenar el valor. El proceso consistiría en cargar información desde FCCS en la dimensión dummy. Estos datos pueden ser cualquier cosa; no importa de dónde provenga la información ni cuál sea su valor, porque lo sobrescribiremos con el valor de DATAKEY almacenado en TDATASSEG_T. En este caso, cargaremos los miembros de la dimensión Custom4 en la dimensión dummy. Custom4 ya se está utilizando, pero una única dimensión de origen puede usarse para cargar múltiples dimensiones de destino.
Requisitos de objetos de DM
Aplicación de destino
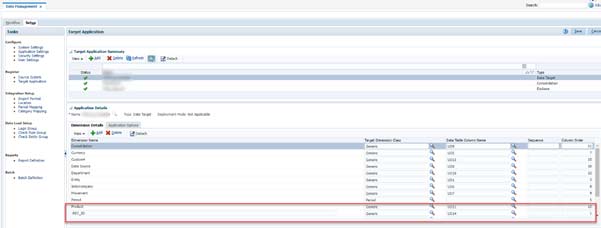
En los detalles de la aplicación de destino, se agregará un nuevo campo de dimensión llamado REC_ID (ID de registro). Esta dimensión se configurará con una clase de “Generic” y apuntará al siguiente nombre de columna disponible en la tabla de datos (en este caso, el siguiente nombre de columna disponible es UD14).
Tenga en cuenta que, dado que REC_ID debe ser el primer campo en el archivo de texto exportado, los campos de orden de columna deben configurarse para que REC_ID sea “1”, y todos los demás campos existentes deben incrementarse en +1 (Consolidation solía ser 10, debe cambiarse a 11; Currency era 6, debe cambiarse a 7; etc.)
Formato de importación
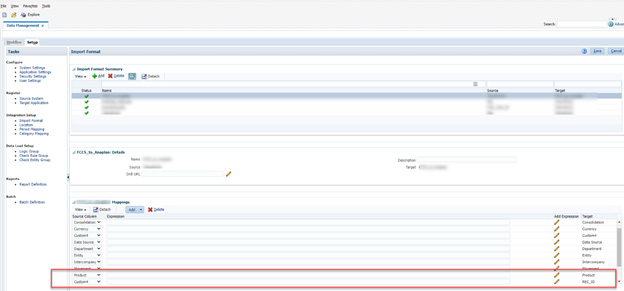
Ya se ha determinado que la migración utilizará la dimensión de origen Custom4 para cargar el campo REC_ID. En realidad, no es relevante qué dimensión se use, ya que todos los datos del origen, sin importar su valor, serán sobrescritos durante el mapeo con el valor de DATAKEY. Se eligió Custom4 porque actualmente no se está poblando ni utilizando en esta implementación de FCCS (todos los datos en FCCS están en “No Custom4”). Pero realmente puede usar cualquier dimensión que desee.
Mapeo
Todas las dimensiones se mapearán uno a uno utilizando comodines ( * a *), con la excepción del campo REC_ID. En este caso, cualquier valor en la dimensión de origen Custom4 se mapeará mediante un script SQL. El script SQL se invocará como parte de los mapeos “Like”.
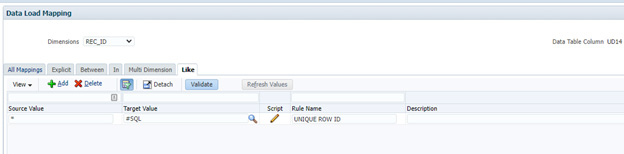
La sintaxis del mapeo SQL está diseñada de tal manera que recuperaremos el valor DATAKEY del registro actual. Una vez recuperado, ese será el valor escrito en el campo REC_ID.
Tenga en cuenta que actualmente no es posible simplemente hacer referencia al campo DATAKEY en el mapeo.
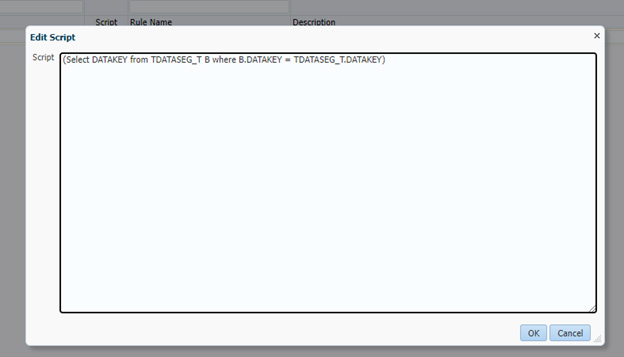
El SQL es
(Select DATAKEY from TDATASEG_T B where B.DATAKEY = TDATASEG_T.DATAKEY) Este mapeo se ejecutará durante el proceso de importación de los datos desde FCCS hacia DM. Después del mapeo, el contenido del campo REC_ID cambiará del contenido de Custom4 (“No Custom4”) al valor DATAKEY del registro actual.
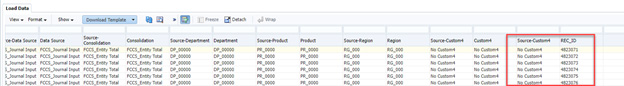
Resultado final
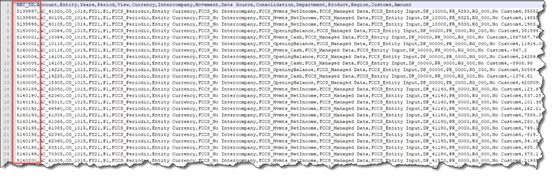
Una vez que el proceso se complete, el archivo de datos incluirá el campo REC_ID como la primera columna del archivo de texto.